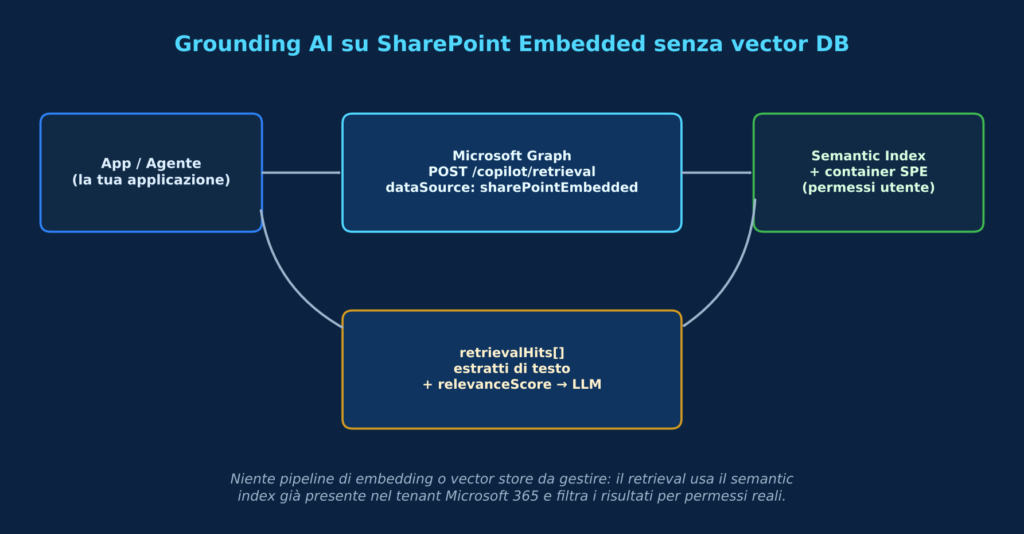
Il problema che tutti conosciamo: costruire un RAG è lento, non è l’app che vuoi fare
Chi ha provato a costruire un’applicazione AI “grounded” sui documenti aziendali conosce bene la lista di lavoro che precede la parte interessante: estrarre il testo dai file, suddividerlo in chunk, generare gli embedding, scegliere e gestire un vector database, sincronizzare periodicamente i contenuti e — il pezzo più trascurato e più rischioso — replicare a mano i permessi di accesso di ogni singolo utente su ogni singolo documento indicizzato. Microsoft ha pubblicato di recente una guida che affronta direttamente questo problema per chi costruisce su SharePoint Embedded: niente vector database da creare, perché il retrieval passa attraverso un’API di Microsoft Graph che si appoggia al semantic index già presente nel tenant Microsoft 365.
Per chi non lo conoscesse, SharePoint Embedded è la variante “headless” di SharePoint pensata per gli sviluppatori: permette di usare lo storage, la sicurezza e la governance di SharePoint dentro un’applicazione personalizzata, senza l’interfaccia utente classica di SharePoint. I contenuti restano all’interno di container nel tenant Microsoft 365 del cliente, e le policy di Microsoft Purview (audit, eDiscovery, retention, DLP, sensitivity label, conditional access) si applicano automaticamente, senza bisogno di ricostruirle nell’app.
Due strade per il grounding, non una sola
La documentazione Microsoft distingue due approcci, a seconda di chi deve avere il controllo sull’orchestrazione:
- Microsoft Foundry Agent Service con una knowledge source SharePoint: il retrieval è gestito interamente da Foundry come parte dell’agente. Scelta naturale se l’agente è già costruito su Foundry.
- Microsoft 365 Copilot Retrieval API: l’applicazione esegue da sé il passo di grounding, mantenendo il controllo completo su prompt, orchestrazione e scelta del modello generativo. È l’opzione da preferire per chi vuole costruire una pipeline RAG personalizzata senza rinunciare alla ricerca semantica gestita da Microsoft.
Come funziona la Retrieval API in pratica
L’endpoint è parte di Microsoft Graph:
POST https://graph.microsoft.com/v1.0/copilot/retrieval
Content-Type: application/json
Authorization: Bearer {access_token}

{
  "queryString": "Quali sono le clausole dell'accordo con Contoso?",
  "dataSource": "sharePointEmbedded",
  "dataSourceConfiguration": {
    "sharePointEmbedded": {
      "containerTypeId": "{containerTypeId}"
    }
  },
  "maximumNumberOfResults": 10
}
Alcuni dettagli tecnici rilevanti per chi deve integrarla:
- Richiede un token delegato: le chiamate app-only (senza utente autenticato) non sono previste, e il permesso Graph necessario è
FileStorageContainer.Selected. - I risultati restituiti sono già filtrati in base ai permessi reali dell’utente autenticato sui file in SharePoint Embedded: non serve replicare la logica di autorizzazione nell’app o nel vector store, il problema più insidioso di un RAG costruito da zero è risolto a monte.
- È possibile restringere la ricerca con
filterExpression, usando una sintassi KQL sulle managed property indicizzate (ad esempioClientMatterCodeOWSTEXT="…"per una colonna di metadati personalizzata). Importante usare=per un match esatto: l’operatore:esegue un term matching più permissivo che può restituire prefissi o valori correlati non voluti. - Il parametro
resourceMetadatapermette di richiedere campi aggiuntivi (titolo, autore, metadati custom) per ogni risultato, a costo di un payload più pesante.
La risposta restituisce una collezione di retrievalHits, ciascuno con un webUrl opaco al file originale e uno o più extracts di testo ordinati per relevanceScore:
{
  "retrievalHits": [
    {
      "webUrl": "https://contoso.com/spe/file",
      "extracts": [
        {
          "text": "L'accordo si rinnova annualmente salvo preavviso di 30 giorni da una delle parti.",
          "relevanceScore": 0.8421
        }
      ]
    }
  ]
}
Da qui in poi il lavoro è quello consueto di un RAG: passare gli estratti come contesto al modello generativo scelto. Un esempio minimale in JavaScript per il passo di grounding:
const response = await fetch(
  "https://graph.microsoft.com/v1.0/copilot/retrieval",
  {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      Authorization: `Bearer ${accessToken}`
    },
    body: JSON.stringify({
      queryString: query,
      dataSource: "sharePointEmbedded",
      dataSourceConfiguration: {
        sharePointEmbedded: { containerTypeId }
      }
    })
  }
);

const data = await response.json();
const grounding = (data.retrievalHits ?? []).map(hit => ({
  url: hit.webUrl,
  text: hit.extracts?.[0]?.text?.trim(),
  score: hit.extracts?.[0]?.relevanceScore
}));
// `grounding` va passato come contesto al modello generativo
Prerequisiti e fatturazione: cosa serve prima di iniziare
- Un’applicazione SharePoint Embedded con almeno un container e il relativo container type ID.
- Fatturazione pay-as-you-go configurata sul container type, senza impegno minimo iniziale.
- Almeno un utente del tenant con licenza Microsoft 365 Copilot: serve per inizializzare il semantic index, ma non è richiesta una licenza individuale per ogni utente che interroga poi la Retrieval API.
- La proprietà discoverability deve essere abilitata sul container type: senza di essa i contenuti non sono visibili a Copilot, ed è un’impostazione governata a livello di tenant, non modificabile unilateralmente dall’app.
Le chiamate alla Retrieval API vengono fatturate tramite il Copilot Studio message meter, con due modelli possibili: standard billing (a carico del tenant che sviluppa l’app) o pass-through billing (a carico del tenant che la utilizza).
Da segnalare anche un dettaglio utile per chi vuole prototipare rapidamente: è disponibile in preview pubblica un server MCP open source (@microsoft/spe-mcp, avviabile con npx @microsoft/spe-mcp) che espone SharePoint Embedded come knowledge source a client compatibili come GitHub Copilot in VS Code, Copilot CLI, Claude e Cursor — utile per esplorare rapidamente i contenuti di un container durante lo sviluppo senza scrivere subito codice di integrazione.
Cosa cambia rispetto a un RAG “fatto in casa”
Il compromesso è chiaro e va valutato con attenzione prima di adottarlo: si rinuncia al controllo diretto sulla pipeline di estrazione, chunking ed embedding — e quindi alla possibilità di personalizzarla finemente — in cambio dell’eliminazione di tre problemi che in un RAG self-hosted sono spesso sottovalutati in fase di progettazione: la gestione del ciclo di vita dell’indice, la sincronizzazione con i permessi reali dei file e i costi operativi di un vector database dedicato. Per team che lavorano già dentro l’ecosistema Microsoft 365 e che devono costruire agenti o assistenti su documentazione interna, è un’opzione che merita di essere valutata prima di investire tempo in un’infrastruttura RAG completamente custom — soprattutto quando il vincolo di conformità sui permessi è più critico della flessibilità del modello di retrieval.
Fonte: Microsoft 365 Developer Blog e documentazione Microsoft Learn.