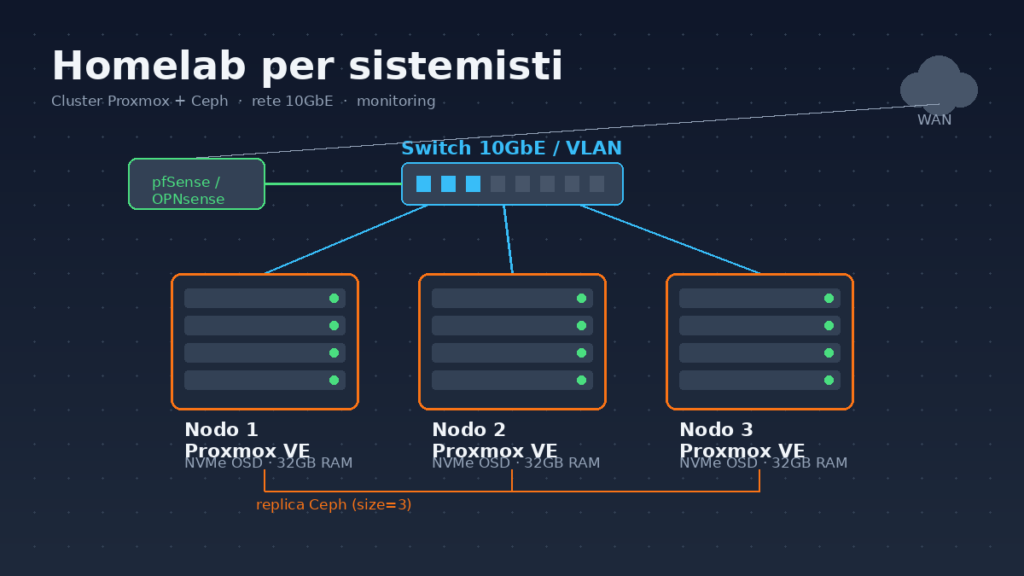
Costruire un homelab non è più un capriccio da hobbista: per chi lavora in produzione è il modo più economico per testare un upgrade rischioso, prepararsi a una certificazione, o semplicemente capire a fondo come si comporta un cluster quando un nodo muore a metà di un rebalance. La differenza fra un homelab utile e un accrocco di hardware riciclato sta tutta nel progetto: rete segmentata, storage ridondato e monitoraggio, non solo “un NUC con Proxmox sopra”. Vediamo come dimensionare un laboratorio realistico nel 2026, partendo da un caso concreto: un cluster Proxmox VE a tre nodi con storage Ceph iperconvergente.
Perché tre nodi, non uno
Un singolo host con Proxmox VE va benissimo per imparare la virtualizzazione, ma non riproduce i problemi reali: failover, quorum, storage distribuito, manutenzione a caldo. Per questo conviene partire direttamente da un piccolo cluster, anche con mini PC usati (un Lenovo ThinkCentre o un mini PC Intel con 8 core sono più che sufficienti).
Il numero dei nodi non è un dettaglio estetico. Proxmox usa corosync per il quorum: con un numero pari di nodi il rischio di split-brain in caso di partizione di rete è più alto. Con Ceph il discorso è ancora più stringente:
- con 2 nodi non si ha ridondanza utilizzabile: non è una configurazione supportata;
- con 3 nodi (replica
size=3,min_size=2) il cluster sopravvive alla perdita di un nodo, ma resta in stato degraded finché non rientra; - con 4 o 5 nodi il cluster può ribilanciare automaticamente i dati e tornare a piena ridondanza senza intervento manuale.
Per un homelab, tre nodi identici sono il punto di equilibrio migliore tra costo e realismo.
Dimensionare CPU, RAM e storage per nodo
Qui è dove la maggior parte delle guide “per principianti” si ferma a un generico “serve un buon processore”. I numeri che contano, se si vuole far girare sia VM che Ceph sullo stesso hardware (configurazione iperconvergente), sono questi:
- RAM: ogni OSD BlueStore punta a 4 GiB di
osd_memory_target. La regola pratica è: RAM totale del nodo > numero di OSD × 4 GiB × 2. Con 2-3 OSD NVMe per nodo, 32 GB sono il minimo ragionevole se il nodo fa solo storage, 64 GB se ospita anche VM; - CPU: si stimano 4-6 thread per OSD su NVMe (1-3 su HDD, da evitare comunque per Ceph). Un mini PC con 8 core/16 thread regge comodamente 2-3 OSD NVMe lasciando margine per alcune VM leggere;
- storage: un disco dedicato al sistema operativo (SSD da 250-500 GB) separato dai dischi destinati agli OSD. Per gli OSD preferire SSD/NVMe enterprise con power loss protection (PLP): i modelli consumer, senza capacitori di backup, crollano in IOPS reali e si usurano prima sotto scritture sostenute tipiche di Ceph.
Per creare un pool Ceph a tre repliche da riga di comando su un nodo Proxmox già aggiunto al cluster:
pveceph pool create vm-storage --size 3 --min_size 2 --pg_autoscale_mode onTenete a mente che con size=3 la capacità utilizzabile è circa un terzo dello spazio raw, e che gli OSD andrebbero riempiti al massimo all’80% per lasciare margine al ribilanciamento.
La rete è il vero collo di bottiglia
È il punto in cui la maggior parte degli homelab fallisce: si investe in CPU e RAM e si lascia la rete a 1 GbE. Ceph raccomanda almeno 10 Gb/s tra i nodi per il traffico di replica e recovery; 2,5 Gb/s è accettabile solo come minimo assoluto su un cluster di tre nodi con carico leggero, mentre 1 GbE rende il recovery dopo un guasto dolorosamente lento e rallenta l’intero cluster durante il rebalance.
Uno switch managed Layer 2/3 con porte 2.5GbE o SFP+ 10G e supporto VLAN è quindi l’investimento con il miglior rapporto beneficio/costo in un homelab, più ancora della CPU del server. Una segmentazione tipica su un unico switch managed:
- VLAN management — interfacce di gestione di Proxmox, iDRAC/iLO, switch, UPS;
- VLAN storage — traffico Ceph pubblico e di cluster, isolato dal resto;
- VLAN VM/produzione-test — le macchine virtuali che simulano i servizi;
- VLAN DMZ/lab esterno — per esperimenti che toccano servizi esposti, dietro il firewall.
Esempio minimale di bridge con VLAN-aware su /etc/network/interfaces di un nodo Proxmox:
auto vmbr0
iface vmbr0 inet static
    address 10.10.1.11/24
    gateway 10.10.1.1
    bridge-ports eno1
    bridge-stp off
    bridge-fd 0
    bridge-vlan-aware yes
    bridge-vids 10-40
Davanti a tutto, un firewall dedicato (non il router del provider) resta la scelta più solida: pfSense e OPNsense sono entrambi basati su FreeBSD e coprono le stesse funzioni base (NAT, VLAN, VPN, IDS/IPS con Suricata). La differenza pratica che conta di più in un homelab è il modello di sviluppo: OPNsense ha un ciclo di rilascio più rapido e un’interfaccia più moderna, pfSense (nella versione CE) è più conservativo e con un ecosistema di pacchetti leggermente più maturo per alcuni plugin storici. Per chi parte da zero oggi, OPNsense è spesso la scelta di default; chi arriva da anni di pfSense in produzione aziendale può restare sulla curva di apprendimento già nota.
Monitoraggio: non aspettate che il disco si rompa per scoprirlo
Un cluster Ceph degradato senza allarmi è un cluster che fallisce silenziosamente. Le due opzioni open source più usate in un homelab sono Zabbix e Checkmk (edizione RAW). Zabbix è più flessibile per metriche personalizzate e scala meglio su grandi infrastrutture distribuite; Checkmk ha una fase di discovery automatica dei servizi molto più rapida ed è generalmente più comodo da configurare per chi gestisce pochi host e vuole risultati utili già nel primo pomeriggio. Qualunque sia la scelta, in un homelab con Ceph vale la pena monitorare almeno:
- stato del cluster Ceph (
ceph -s, PG non sani, OSD down); - latenza e SMART degli OSD;
- utilizzo di CPU/RAM per nodo e per VM;
- stato dell’UPS tramite NUT (Network UPS Tools), per gli spegnimenti puliti automatici;
- temperatura e stato ventole, specie con raffreddamento passivo.
Un piccolo UPS da 1U e 500VA regge tipicamente 20-30 minuti con un carico di due access point PoE e un piccolo switch, tempo più che sufficiente per uno shutdown ordinato via script invece di uno stop brutale del cluster.
Conclusione
Un homelab ben progettato non è il numero di terabyte o il modello di CPU: è l’insieme di scelte — tre nodi invece di uno, rete a 10 Gb dedicata allo storage, VLAN che separano gestione e produzione, monitoraggio che avvisa prima che l’utente se ne accorga — che lo rende una palestra credibile per chi lavora davvero con questi sistemi. Partire in piccolo (anche con hardware usato da poche decine di euro a nodo) e scalare componente per componente resta la strada più efficace per arrivare, con budget contenuto, a un ambiente di test che si comporta come la produzione.
Fonte: Home Lab Beginners Guide: Hardware (2026), LinuxBlog.io.